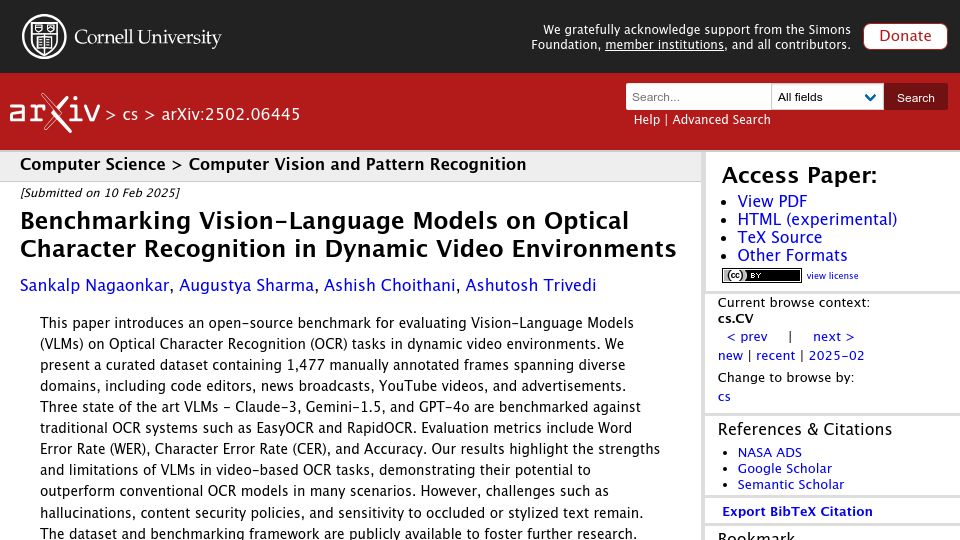
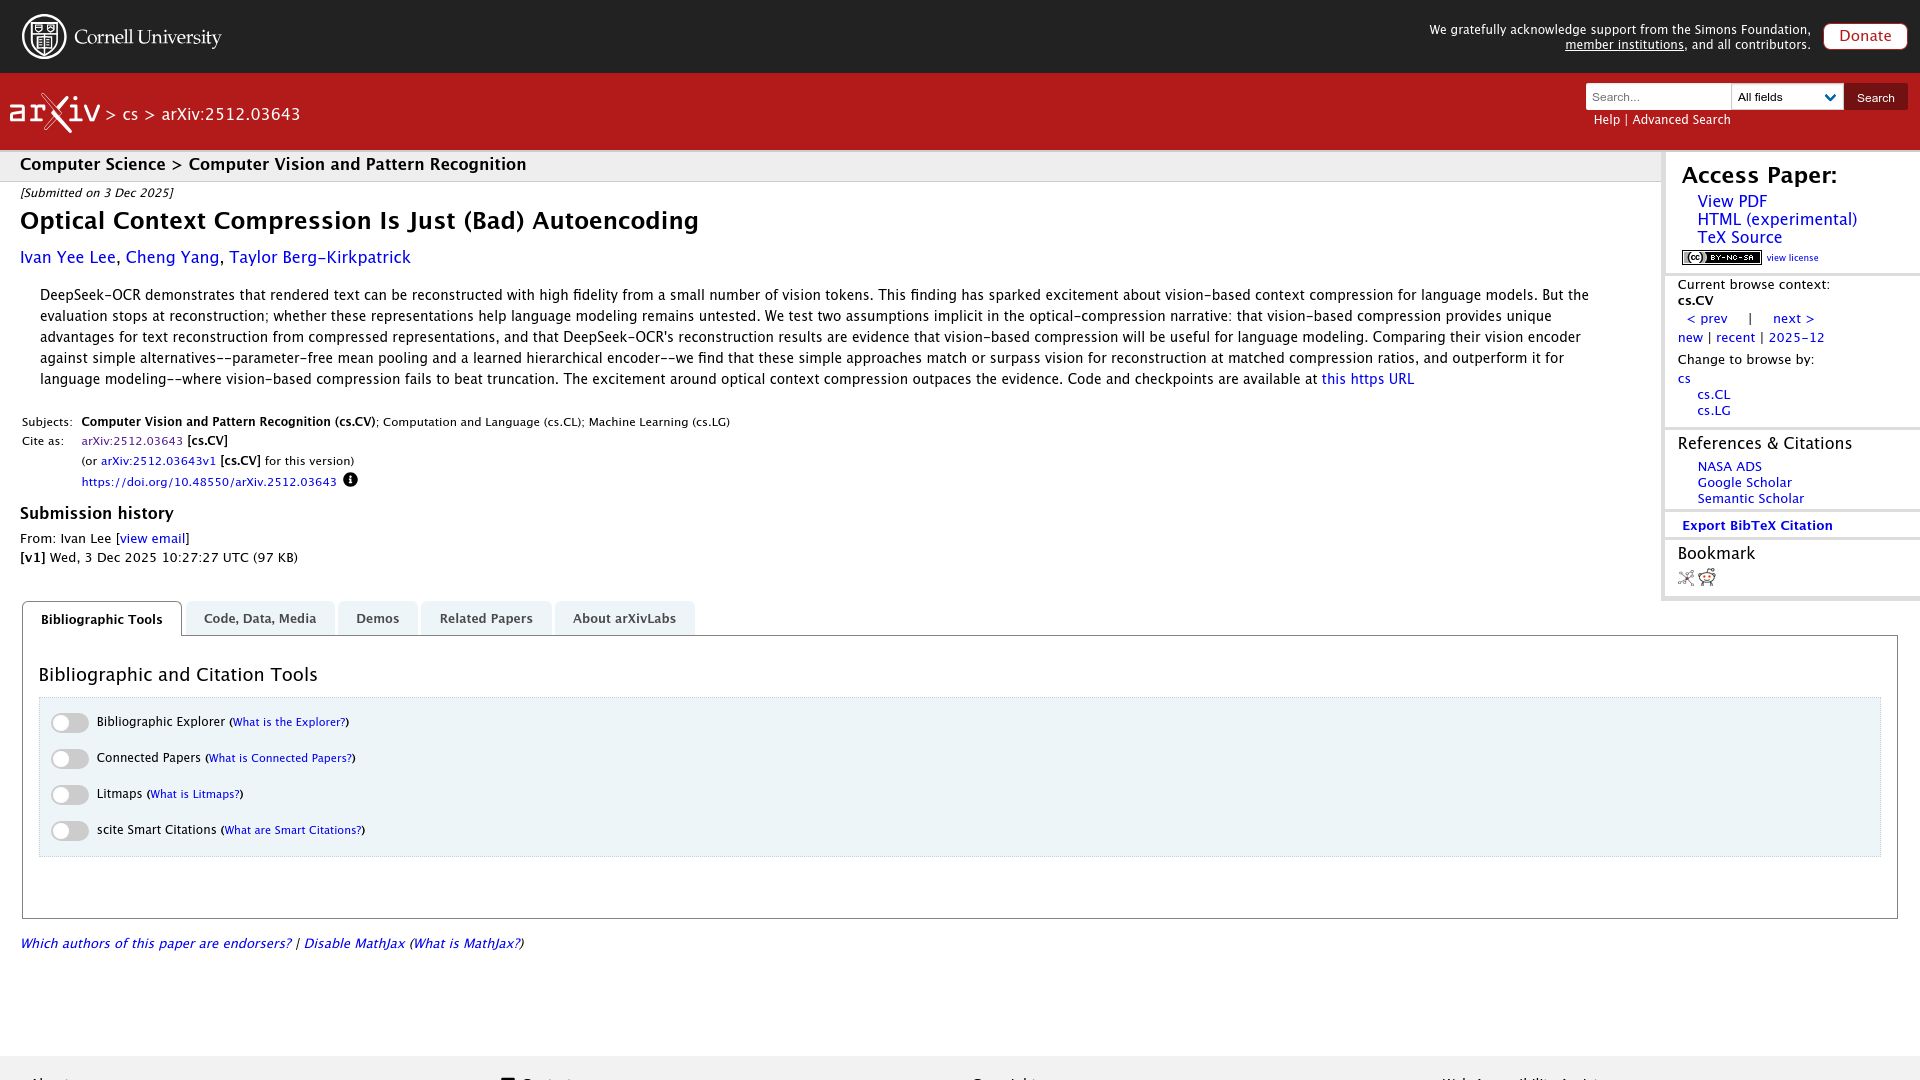
First screen, captured .
Looks similar
Google Predicts the Flu Again(arxiv.org)
7 points by tgoog | 6 comments
PaLI-3 Vision Language Models(arxiv.org)
158 points by maccaw | 22 comments
First screen, captured .
7 points by tgoog | 6 comments
158 points by maccaw | 22 comments