First screen, captured .
Looks similar
Self-Adapting Language Models(arxiv.org)
210 points by archon1410 | 61 comments
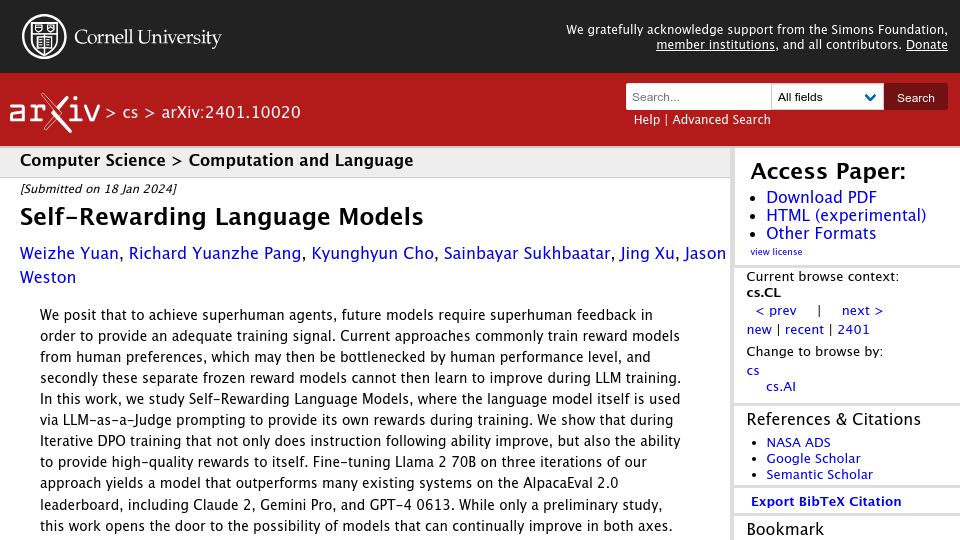
Self-Rewarding Language Models(arxiv.org)
56 points by jph00 | 49 comments
First screen, captured .
210 points by archon1410 | 61 comments
56 points by jph00 | 49 comments