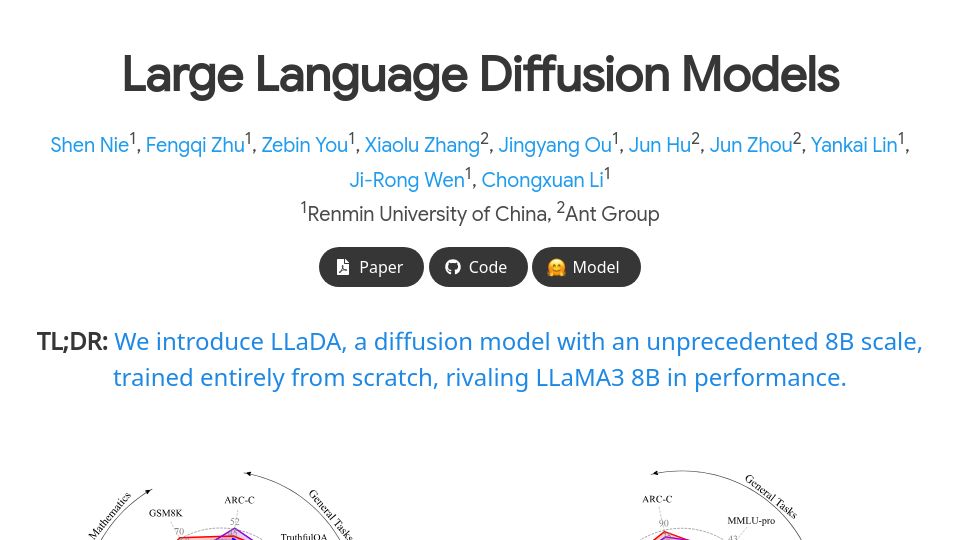
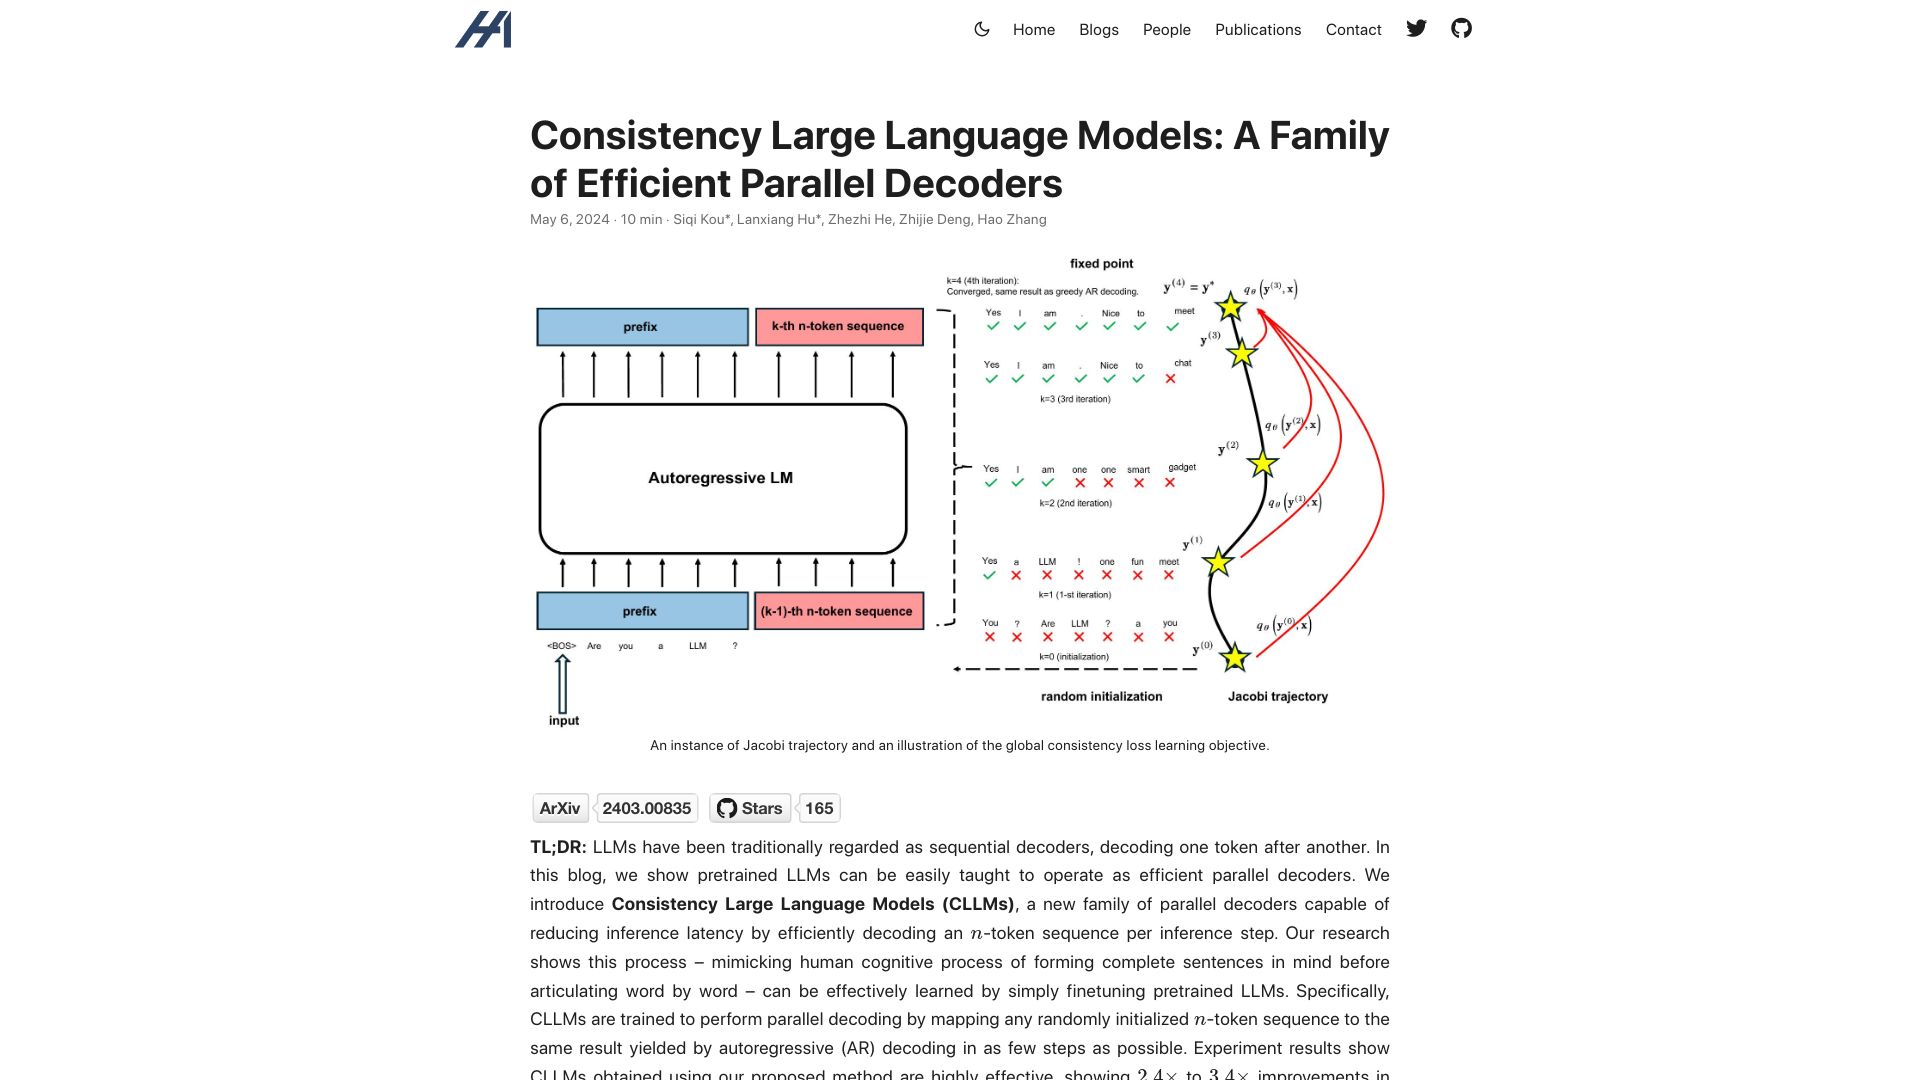
First screen, captured .
Looks similar
Related stories
AI coding has made CI a bottleneck, so we reworked ours to keep up(linear.app)
300 points by julian_digital | 367 comments
A Linear engineering blog post explaining how AI-assisted coding increased CI load and how the team reworked its CI pipeline to keep up.
Some thoughts on LLMs and software development(martinfowler.com)
378 points by floverfelt | 347 comments
Martin Fowler's blog post sharing scattered thoughts on the state of LLMs and AI and their effect on software development.
AI Made Writing Code Easier. It Made Being an Engineer Harder(ivanturkovic.com)
343 points by saikatsg | 242 comments
Blog post by Ivan Turkovic arguing that AI tools make producing code easier while making the broader job of being a software engineer harder.
Turning GLM-5.3-Flash into a Jev-like decision model(privatemode.ai)
116 points by flxflx | 50 comments
Privatemode AI blog post describing how to prompt GLM-5.3-Flash so its first output token gives a decision in a single forward pass, benchmarked against Jev and Laya.
Getting AI to work in complex codebases(github.com)
442 points by dhorthy | 368 comments
A GitHub markdown document from HumanLayer describing advanced context engineering techniques for getting AI coding agents to work in complex codebases.
We should be more ambitious with the software we build(danluu.com)
849 points by ltratt | 728 comments
Dan Luu essay arguing that advancing AI coding models let developers build more ambitious software, citing pgrust, a regex engine, ripgrep fork, and board game AI projects.