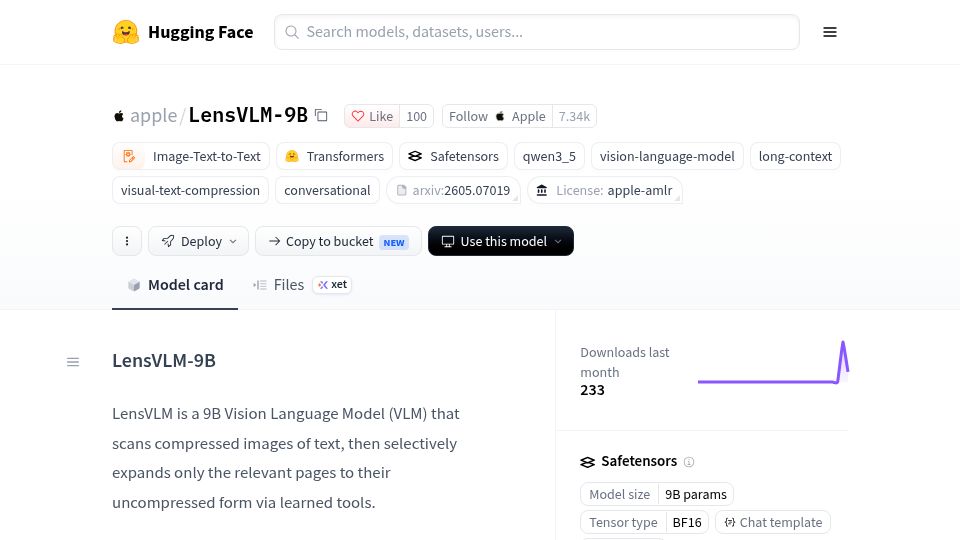
LensVLM: Compressing long context as images, expanding only relevant pages(huggingface.co)
77 points by victormustar | 7 comments
Hugging Face model card for Apple's LensVLM-9B, a vision language model that reads compressed images of text and expands only relevant pages via learned tools.